

Head of hype @lobehub Prev @listenhub @Sapient_Int 没啥好看的,也就发点AI相关的内容🫡 同名小红书4万粉丝,公众号01Founder(长文首发) 观点仅代表个人 更多请访问网站⬇️(欢迎商务、合作
Singapore
Based in Japan
- Tweets 12,400
- Following 2,967
- Followers 41,602
- Likes 26,714


卧槽,美国刚抓了一个向中国走私GPU的华人老板,涉案金额超过 3 亿美元。
刚刚,美国司法部公布,加州科技公司 Earthmade Computer 的老板 Greg Lui(又名 Yiu Kong Lui)被捕,并被联邦大陪审团起诉。
检方指控,从 2023 到 2024 年,他和同伙购买受美国出口管制的高端 GPU 服务器,然后先发往马来西亚、新加坡等地,再转运到中国。
为了绕过审查,他们被指使用虚假的最终用户和目的地文件。
DOJ 甚至提到,整个过程中还出现了用 dummy servers 应付检查、通过复杂转运路线隐藏真实目的地的操作。
而走私量相当夸张,仅 2024 年 1 月到 10 月,Earthmade 就从两家马来西亚公司收到了超过 1.76 亿美元。
其中一笔已经被检方单独拎出来:27 台服务器,总价约 761 万美元。
媒体援引案件材料称,这批服务器搭载的是 Nvidia H100 GPU,先从洛杉矶运到吉隆坡,随后又被转运给中国买家。
我还顺手去看了一眼 Earthmade 的官网,更有意思了。
他们公开卖的基本就是现在 AI 算力市场最核心的那批东西:NVIDIA H100/H200、B300,甚至 GB300 NVL72 都在产品列表里。
Greg Lui 现在面临三项指控:违反出口管制相关法律的共谋、向境外走私,以及洗钱共谋。
三项罪名各自的最高刑期分别为 20 年、10 年和 20 年。目前这些都还是检方指控,案件尚未定罪。
这案子比较值得关注的一点是,美国对 AI GPU 出口管制的执法,已经不只是盯着芯片从哪里出境了。
中转国、服务器经销商、最终用户文件,甚至资金流,现在都在一起查。
3 亿美元的服务器到底最终流向了哪些买家,后面应该还会继续往下挖。
是不是新风暴的开始呢?

7
8
83
26,980
牛逼,现在 Claude Code 可以自己改自己了!!
刚刚 Anthropic 给 Claude Code 上线了一个新东西:Mods。
简单来说就是,现在你可以让 Claude 直接改 Claude Code 自己了。
以前的 Skill、MCP、Plugin,更多还是给 Claude 增加知识、工具和工作流。
Mod它本质上是一组 JavaScript / TypeScript event handler,可以直接监听 Claude Code 里的事件,包括 Prompt 提交、Tool Call、Turn 开始/结束、命令执行,甚至 UI Render。
然后你可以选择观察、改写,或者直接接管这个事件。
比如:
你可以在 Claude 执行 rm -rf 之前,自己插一个风险确认界面;
可以把某些 Tool Call 拦下来,修改参数、拒绝执行,甚至自己处理;
可以直接重画 Claude Code 的 UI,加按钮、Pane、输入框;
甚至可以把某一次模型请求转发给另一个模型(转给DSV4.1🤣)。
而且不用搞什么复杂 SDK。
写几行 TypeScript 就能做,也可以直接跟 Claude Code 说你想要什么,让 Claude 帮你把 Mod 写出来。
最后还是作为 Plugin 分发,用 /plugin 安装,CLI 和 Desktop 都支持。
最有意思的是,Anthropic 官方表示他们已经开始这么干了。
现在 Claude Code 里的 /diff,以及 AGENTS.md 支持,本身就是用 Mod 实现的,而且源码直接放在 Claude Code 仓库里。
我感觉这一步其实比再加十个 Skill 都重要。
因为 Skill 是在改 Agent 知道什么,MCP 是在改 Agent 能调用什么。
CC的Mod 开始改的是 Agent Harness 本身。
Claude Code 正在慢慢从一个固定的 AI Coding 产品,变成一个你可以自己魔改的 Agent Runtime。
甚至以后大家用的可能都叫 Claude Code,但每个人手里的 Claude Code,已经完全不是同一个东西了。
不过Mod这个功能的权限也是真的大。
官方直接提醒,Mod 可以接触会话、文件、进程和网络,甚至影响 Tool Permission,所以第三方 Mod 以后估计也会成为新的供应链安全重灾区。
看起来我们终于把微软大战Code的那插件生态那套快乐与灾难,一起搬进 Agent 里了。
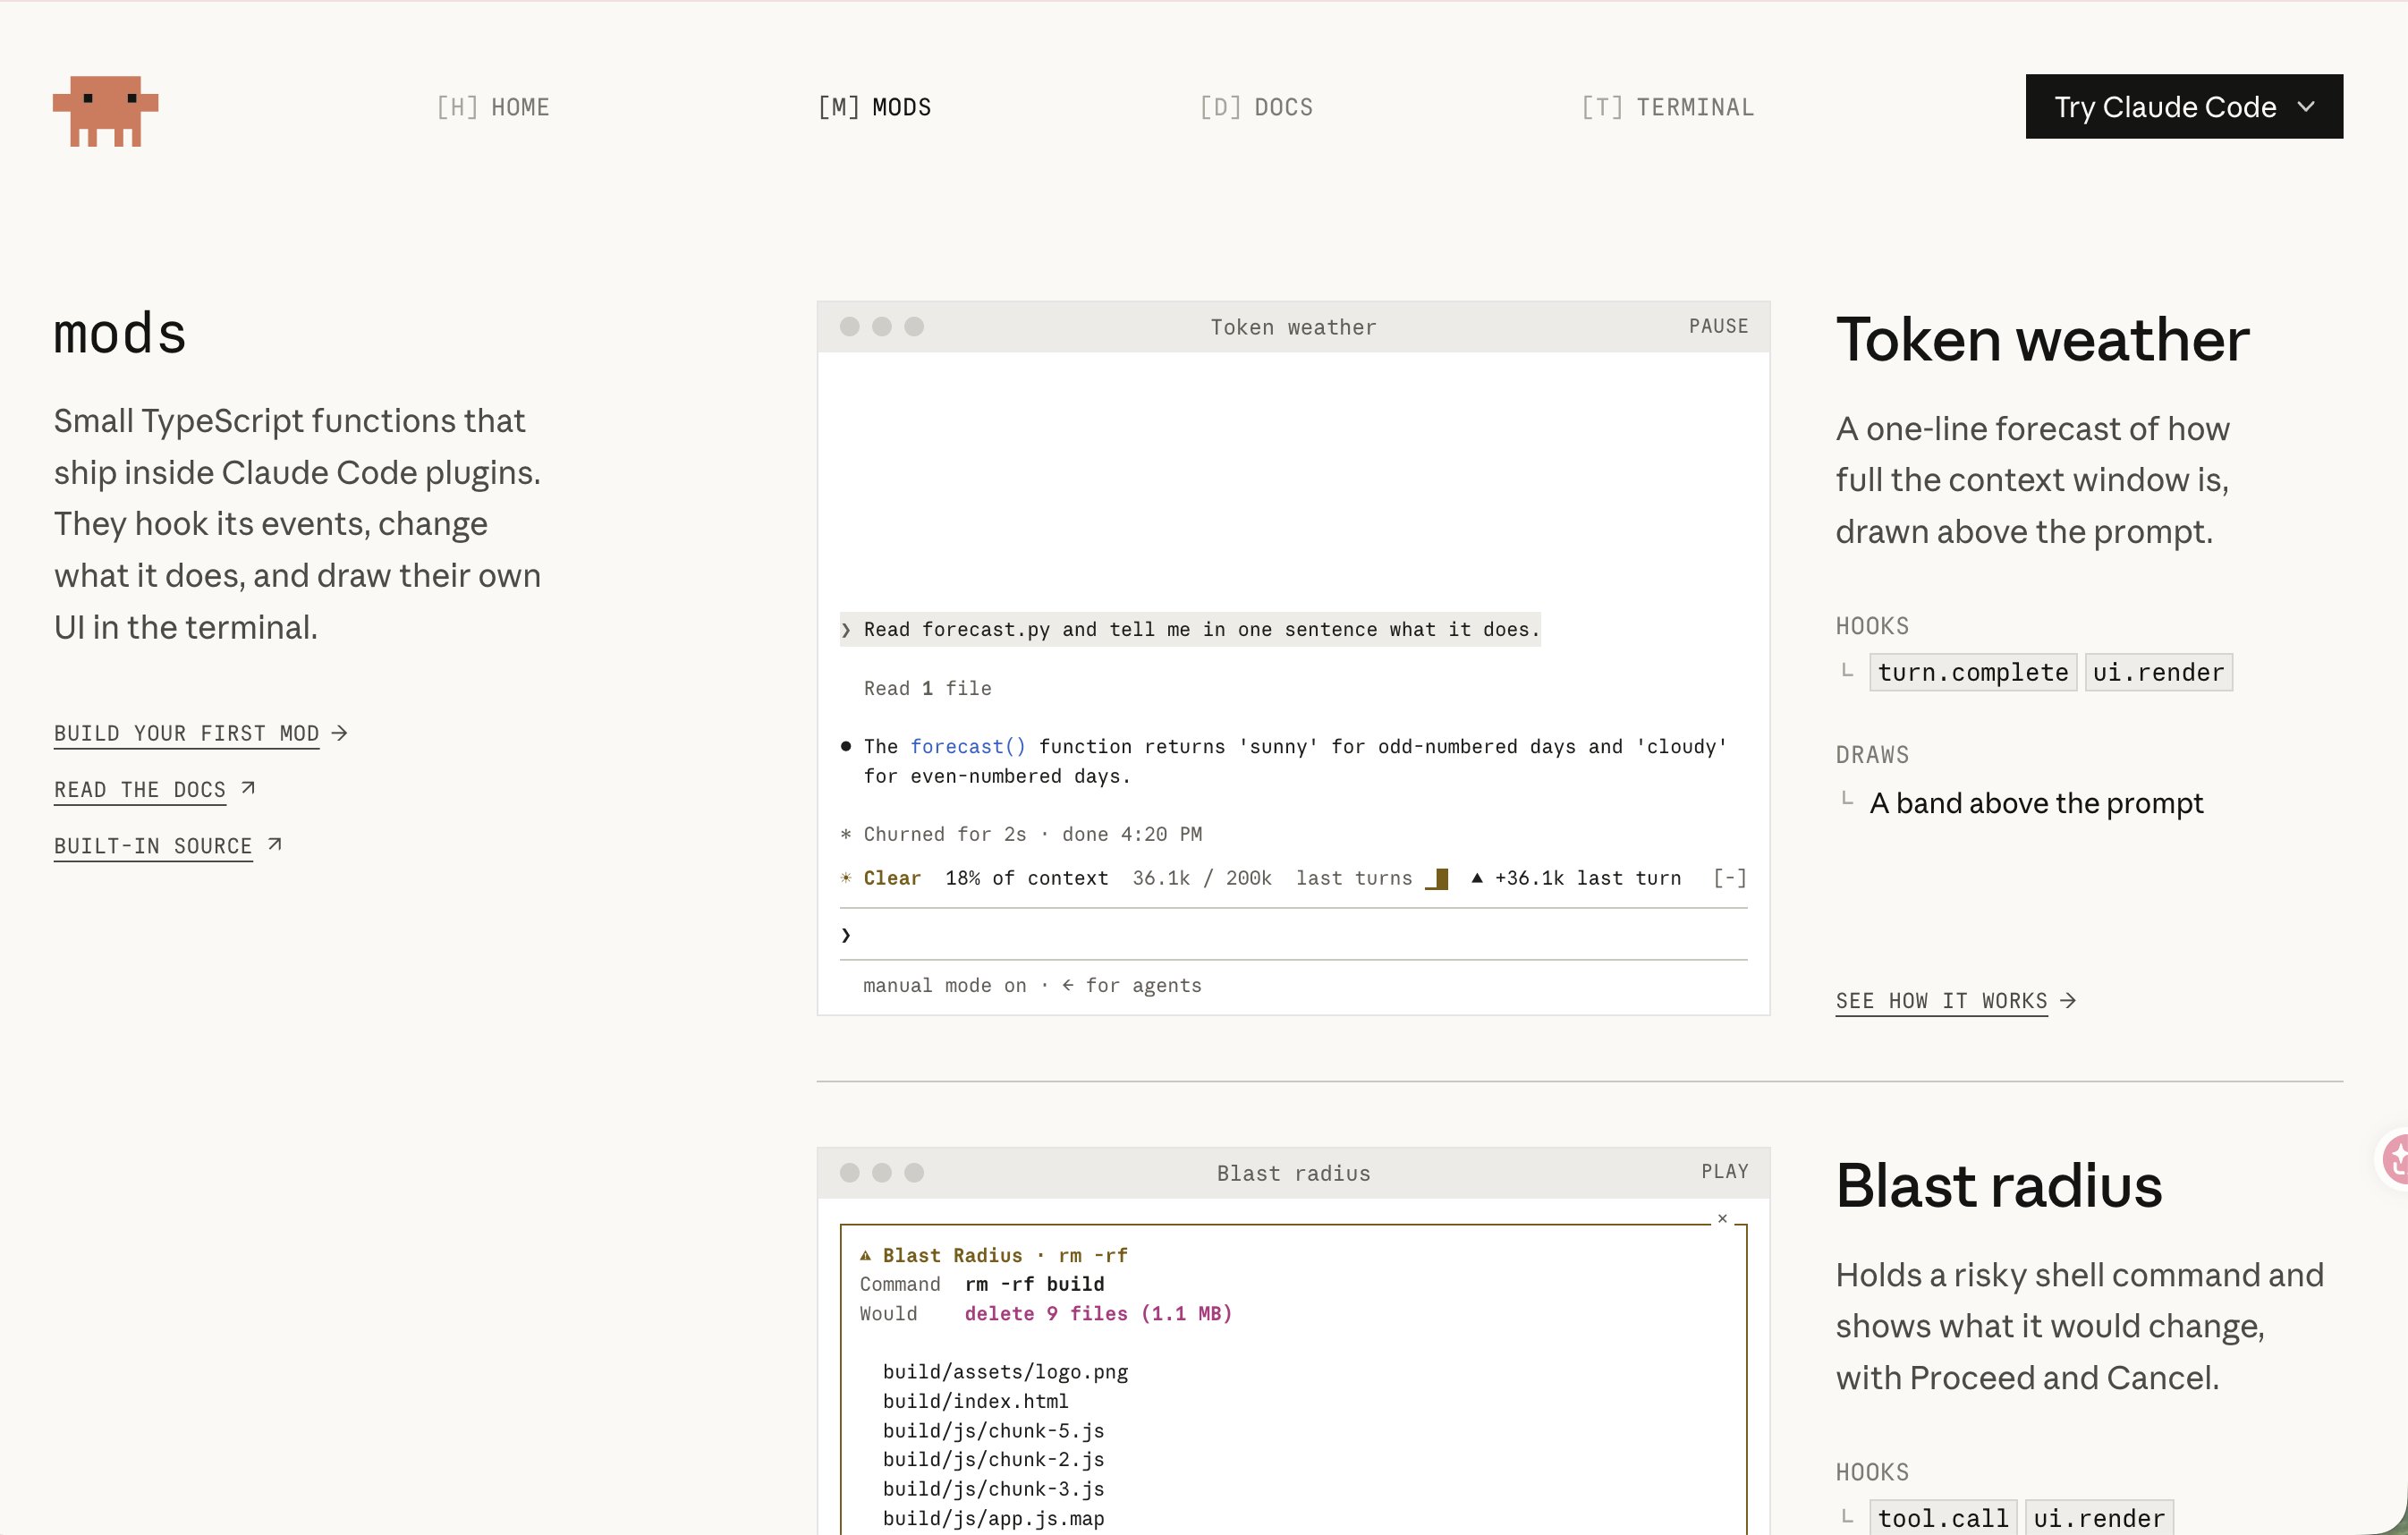

You can now mod Claude Code:
- Change how it behaves
- Customize the UI
- Swap in your own features
Write one with a few lines of TypeScript, or have Claude build it for you. Mods ship inside plugins, so you install them with /plugin in the CLI or desktop app.
A few examples:

19
23
191
47,357
有意思,Cloudflare 也微调并开源了两个 Jev 模型。
刚刚 Cloudflare 开源了 Clef,一个基于 Qwen3.8-27B 后训练出来的 Decision Model,同时还有一个基于 Qwen3.5-9B 的 Clef-flash。
如果你之前关注过 Jev ,应该知道这类模型它不负责和你聊天,也不负责写长篇大论。
它只负责一件事:做决定。
比如 Agent 跑到某一步,需要判断:
这个任务该调用哪个 Tool?
要不要继续执行?
结果有没有通过?
应该 Routing 给哪个 Agent?
是否需要 Human-in-the-loop?
技术上,Cloudflare 冻结了 Qwen3.8-27B 的 Backbone,然后训练 rank-256 LoRA 和一个专门的 Joint Schema Head。
推理的时候 Qwen 只做 Prefill,后面的选项通过专门的 Head 并行打分。
速度方面在Cloudflare 自己 Decision Index 的测试里:
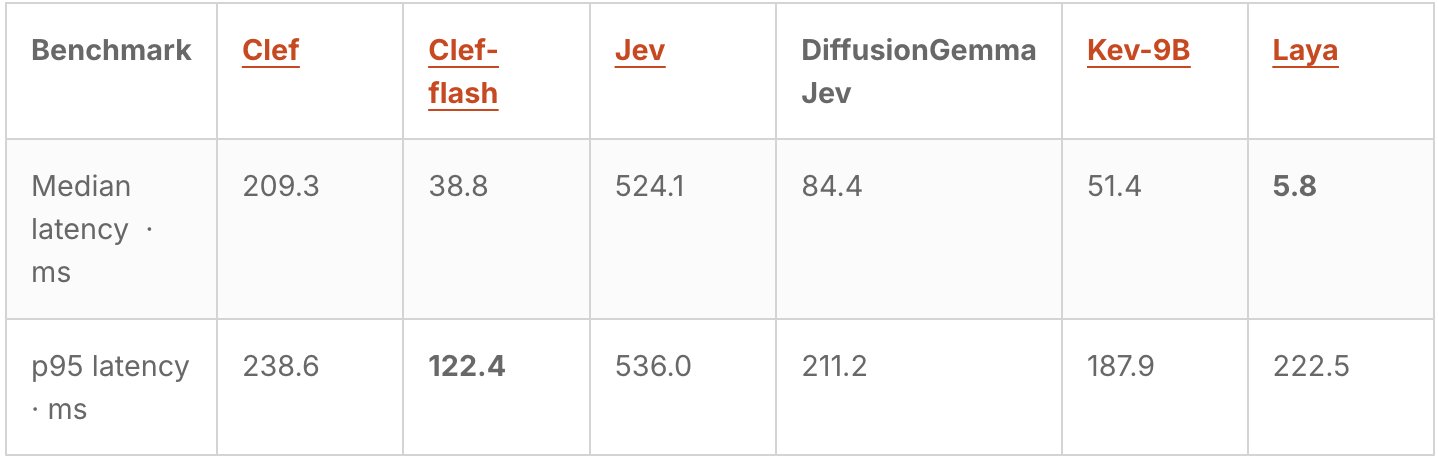
Clef median latency 209.3ms,
Clef-flash 只有 38.8ms,
Jev 是 524.1ms。
在agentic任务的bench表现上也不错
BFCL 上 Clef 98.5,Clef-flash 98.8;
API-Bank 则是 91.9 和 93.1。
当然,它也不是一个“更强的 Qwen”。
像 GPQA、MMLU-Pro 这类通用知识和推理任务,Clef 明显不如完整的通用模型。
因为它压根没想干这个。
它是在用通用生成能力,换取更稳定、更快、更便宜的 Decision。
感觉不错,已抄送我们研发频道(



We are introducing Clef and Clef-flash, open-source decision models hosted on Workers AI for high-speed classification and agentic workflows. cfl.re/3Vlqb9P #BirthdayWeek
8
13
91
17,188


太牛逼了,A股上市芯片公司寒武纪前高管向公司索赔278亿元🤯
刚看到昨天寒武纪发的公告,公司原副总经理梁军把对寒武纪的索赔金额,从42.87亿元直接提高到了278.32亿元。
梁军2022年初从寒武纪离职。
按照寒武纪的说法,公司随后依据梁军本人签署的《持股计划B》执行股权回购,但梁军拒绝配合,双方从2023年开始一路打官司。
到现在,梁军和寒武纪股权激励平台、管理主体之间相关的案件一共已经有6起,梁军全部败诉,其中回购案件已经进入司法强制执行阶段。
但事情还没完。
梁军另外以劳动争议为由,要求寒武纪赔偿他的股权激励损失。
一开始索赔42.87亿,现在直接改成了278.32亿,涨了差不多6.5倍。
这个278亿是怎么来的也很有意思。
根据公告,经过2025年度利润分配和资本公积转增股本后,相关份额间接对应的寒武纪股票增加到了约1717万股。
梁军计算损失时,采用的是寒武纪从2024年1月2日到提交申请期间的最高股价1620元/股。
也就是说,这个索赔金额基本是拿历史最高价去算自己失去的那部分股票值多少钱。
不过这里还是要强调一下:278.32亿目前只是梁军一方提出的诉讼请求(法院不太可能支持)。
这起劳动争议案件目前甚至还没有开庭。
寒武纪方面也明确表示不认可这一诉求,认为此前生效判决已经确认梁军离职触发了股份回购条款。
278亿是什么概念。
很多上市公司一辈子的利润都未必有这么多。
这是我见过金额最离谱的离职高管股权纠纷之一了。。。。

5
19
10,522
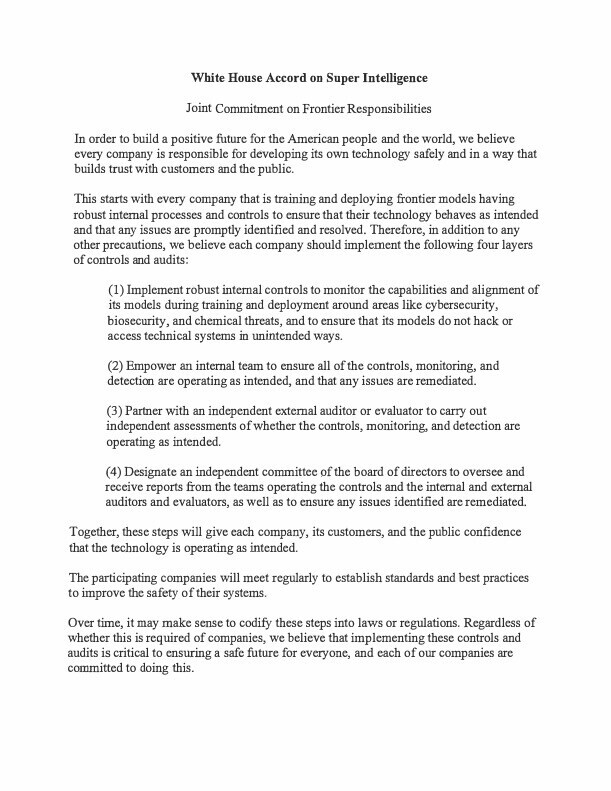
刚刚,白宫把 Google、Anthropic、Meta、OpenAI、xAI、NVIDIA 拉到了一起,签了一份《White House Accord on Super Intelligence》。
在场签字的人都是美国现在最核心的 AI 领导者:Sundar Pichai、Dario Amodei、Mark Zuckerberg、Greg Brockman、Elon Musk、Jensen Huang,以及特朗普(aha)。
我仔细看了下协议,篇幅其实非常短,但里面有一条挺有意思:
前沿模型公司需要建立内部控制,持续监测模型在网络安全、生物安全、化学威胁等领域的能力和对齐情况,并确保模型不会以非预期方式 hack 或访问技术系统。
这基本就是把这段时间越来越频繁出现的 Agent 越权、模型逃逸、自动化网络攻击问题,正式加到白宫文件里管控了。
整个协议实际上要求了四层机制:
模型训练和部署阶段的内部安全控制;
独立的内部团队负责检查这些控制是否真的有效;
引入外部独立审计或评估机构;
董事会设立独立委员会,直接监督这些安全问题。
但这目前不是法律,而是一份自愿协议(意味着没屁用)。
北美的太阳特朗普把它称为 morally binding,也就是道义上的约束。
协议里还写了一句,未来可能有必要把这些措施进一步写进法律或监管。
几家公司之后也会定期开会,继续制定共同的安全标准和最佳实践。
顺便还有个很抽象的细节:这份讨论 Super Intelligence 的白宫文件,在特朗普签名下面把 President of the United States 写成了 President of the Unites States。
人类开始治理超级智能的第一天,先把自己国家名字拼错了🤣



2
2
16
6,664


🚨DeepSeek又开源啦!
刚刚,@DeepSeek 正式开源了一整套面向华为昇腾的基础设施组件。
简单说,就是把此前在 NVIDIA 平台上跑通的那套核心基础设施,开始系统性地搬到昇腾上:
TileLang、DeepGEMM、DeepEP、TileKernels、FlashMLA、DeepSelect,基本一一对应。
这里面我最关注的其实是 TileLang。
它本质上是一个用来写高性能 AI 算子的高级语言。以前想把 GPU/NPU 性能榨干,开发者往往需要直接写 CUDA、Ascend C 这种很底层的代码,复杂,而且换一套芯片又得重新适配。
TileLang 相当于往上抽了一层:你用更简单、接近 Python 的方式写 GEMM、Attention、量化这些算子,它再负责把代码编译到 NVIDIA、AMD、昇腾等不同硬件上。
有点像 Triton,但 TileLang 从一开始就在往多硬件后端走。
更重要的是,它不是只追求“好写”,而是希望好写的同时还能把硬件性能吃满。
DeepSeek V4 系列训练里的大量算子,现在已经是用 TileLang 实现的。
这次昇腾版本直接把底层 Ascend C 指令封装起来,并且 DeepSeek 训练里用到的每一个 TileLang 算子,目前在昇腾上都有对应实现。
另外几个开源的仓库也基本把LLM训练最核心的底层能力补齐了:
DeepGEMM 做矩阵计算;
DeepEP 做 MoE 大规模跨卡通信;
TileKernels 放各种常用训练/推理算子;
FlashMLA 做稀疏注意力;
DeepSelect 做高性能数据筛选。
我翻了一下刚开源的仓库,DeepGEMM Ascend 在官方给出的部分 Dense GEMM 测试里,最高已经做到硬件理论上限的 99.8%。
更有意思的是,这次 DeepSeek 还明确提到了和华为一起做 Ascend 950 的 128 卡超节点,对计算和通信做了深度优化。
国产算力过去一个很现实的问题就是:硬件出来了,但真正好用的软件栈、算子库、通信库和开发工具,往往还得重新磨很久。
现在 DeepSeek 相当于把自己已经验证过的一套东西直接开出来。
希望后面这套栈真的能在更多团队、更多国产芯片上复用。

44
37
358
26,503


神了....第一次见Claude Sonnet把同代的Opus超了。。
今天早上,Anthropic 正式发布了 Claude Sonnet 5.5。
我本来以为 5.5 系列会先让 Opus 独占一阵子,结果才隔几天,Sonnet 也发了。
这次最大的变化其实就三个字:更实用。
相比上一代的Sonnet 5,Sonnet 5.5的速度快了 30%+,也是目前最快的 Sonnet。
单次任务成本最高降低 30%。
注意不是 API 单价直接降了,价格还是 $2/M 输入、$10/M 输出,只是完成同样任务需要的 Token 更少。
Agent / Coding 能力涨得很猛。
官方 Terminal-Bench 4.0 从 Sonnet 5 的 10.3% 直接到了 70.6%,甚至超过了 Opus 5.5 在这项测试里的成绩。
这次 Anthropic 对 Sonnet 的定位也越来越清楚了:
Opus 5.5 继续负责复杂、需要大量判断的任务;
Sonnet 5.5 则是日常 Coding、修 Bug、做文档/PPT/表格这种高频工作的主力模型。
官方甚至专门提了一句,它的设计能力也不错。
我感觉这个方向其实挺对的。
Agent 真正大规模跑起来之后,很多时候大家缺的已经不是一个再聪明 5% 的模型,而是一个足够聪明、响应更快、跑一天还没那么贵的模型。
而 Sonnet 恰好一直就是 Claude 真正干活的那一档。
现在比较想实测的反而不是 benchmark,而是 Sonnet 5.5 在 Claude Code 里到底能不能明显感觉到这 30% 的速度提升,以及长任务会不会真的省 Token。
如果这两件事成立,这次升级可能比数字看起来更有意义。
我记得之前ant的员工说这一代有haiku🤔
期待一下haiku5.5


Introducing Claude Sonnet 5.5, the second model in the Claude 5.5 family.
It’s a clear upgrade over Sonnet 5, runs more than 30% faster, and costs up to 30% less for most work.

30
3
46
16,174


刚刚, @Kling_ai 官方发布了最新的Kling4.0模型的内测活动,同时公布了Kling4.0模型的大量细节。
Kling4.0将于10月份正式上线,同时自9月28日开始,Kling4.0Flash将开启早期内测。
真实、可控、专业,是Kling 4模型升级的核心方向。
Kling4.0在画面真实感、创意可控性和叙事完整度方面实现大幅提升,并在视听表现、多关键帧、口型匹配、文字生成、创意复刻等能力上带来全新突破。
面向高频创作场景,Kling 4.0 Flash 兼具高性价比与高效的生成速度,助你轻松完成视频创作。
目前有这几个核心升级点:
1、单次最长直接做到 30 秒
4.0 单次可以做到最长 30 秒,Flash 版本最长 20 秒,长视频还可以继续往后延。
2、最多 10 个 Keyframe
你不再只是给第一帧、最后一帧,然后祈祷中间模型别发疯,而是可以直接指定多个关键剧情节点。
某种意义上已经越来越像拿 storyboard 在“导演”模型了。
3、 一次最多塞 15 个 Reference
包括图片、视频、角色、声音等不同素材。
这意味着角色一致性、商品一致性、动作参考、声音参考这些东西,可以在一个任务里一起控制。
4、视频本身也能直接改
运镜、风格、背景不满意,可以单独改,而不是整段重新抽卡。
甚至还加入了 4K/HDR、21:9、原生声音、多语言这些能力。
感觉是一次非常大的升级!

25
29
7,599




中国第一大模型华为盘古又开源了🫡
刚刚,华为盘古大模型团队开源了 openPangu-2.0 的预训练代码、SFT 代码和后训练 RL 代码。
现在大部分所谓开源大模型,基本还是权重 + 推理代码。
你可以部署、可以魔改,但模型怎么被训出来的 Pretrain、SFT、RL recipe国产,往往还是黑盒的。
此前华为已经陆续开了模型结构、Flash/Pro 权重、推理代码和训推算子;
其中 Pro 是 505B 总参数、18B 激活,512K Context,预训练用了约 34T Tokens。
现在预训练 + SFT + RL 代码再补上,基本已经开始覆盖一套大模型从训练到后训练的完整链路。
而且这件事放在华为昇腾生态里看会更有意思。
华为这两年其实一直在干一件事:不只是卖卡,而是把 CANN、PyTorch 适配、模型、训推算子、训练系统这一整套东西逐渐打开。
华为自己披露,目前基于昇腾+CANN 的原生训练模型已经超过 40 个。
所以我觉得 openPangu 真正想做的,可能也不是再造一个国产模型排行榜选手。
它在回答一个很重要问题:
如果未来有人真的想在昇腾上,从头训一个自己的大模型,到底有没有一套可以直接抄作业的开源参考?
现在华为自己给出了参考答案。
也算是遥遥领先了。。。


54
15
144
48,158


看起来OpenAI即将公布新的ChatGPT订阅方案👀
目前ChatGPT Pro 的5x和20x已经改名了,现在分别叫Pro Standard和Pro More,定价页也删掉了之前 5x / 20x Plus 用量的描述。

52
3
126
85,897


我开始怀疑Anthropic是歧视黄种人了.....
刚看到韩国朋友表示,自己的账号突然被 Anthropic 直接停用了。
没有提前警告,账号直接显示This organization has been disabled.
更离谱的是,评论区有别的韩国人提醒他:可能是因为付款时,Billing Address 用韩文填写了。
博主自己一看,还真是韩文地址,于是怀疑这可能触发了 Anthropic 的风控。
但韩国本身就是 Claude 官方支持地区,Anthropic 也没有公开说韩文地址会导致封号。
而且今年 GitHub 上已经出现过不少类似投诉:正常 Pro 用户突然收到 suspicious signals / Usage Policy 的封禁邮件,有人甚至连官方申诉页面都进不去。
模型越来越强是一回事,但账号风控如果还是这种宁可错杀、不太解释、申诉又困难的状态.....
A/畜什么时候死啊。。。。。


언행불일치는 그 회사 사장만 하는 줄 알았는데.
클로드 Pro 결제 직후 개막차단 당하는 사람들이 꽤 있다곤 들었는데 그게 제가 될 거라곤.
Oai의 상냥한 경고랑 다르게 시작부터 불꽃꺼져싸다구 맞으니 그 성능이 얼마가 됬든 쓰고 싶은 생각이 팍 사라져 버리네요. 그래놓고 이의제기 신청했는데 '이의제기는 1회밖에 안됩니다.'경고 안내 넣어놓은 것도 그렇고 이게 과연 고객한테 물건을 파는 기업의 태도인가 싶구요. 연휴에 카드사 대응 될 지 모르겠는데 그냥 카드사 분쟁 환불 절차 들어가는 게 빠를 거 같군요.
누워서 눈 감을때마다 짜증나서 깨는 걸 반복하다가 그냥 안 자고 제사 지내러 갈 생각.

27
4
165
51,827
我开始怀疑Anthropic是歧视黄种人了.....
刚看到韩国朋友表示,自己的账号突然被 Anthropic 直接停用了。
没有提前警告,账号直接显示This organization has been disabled.
更离谱的是,评论区有别的韩国人提醒他:可能是因为付款时,Billing Address 用韩文填写了。
博主自己一看,还真是韩文地址,于是怀疑这可能触发了 Anthropic 的风控。
但韩国本身就是 Claude 官方支持地区,Anthropic 也没有公开说韩文地址会导致封号。
而且今年 GitHub 上已经出现过不少类似投诉:正常 Pro 用户突然收到 suspicious signals / Usage Policy 的封禁邮件,有人甚至连官方申诉页面都进不去。
模型越来越强是一回事,但账号风控如果还是这种宁可错杀、不太解释、申诉又困难的状态.....
A/畜什么时候死啊。。。。。
언행불일치는 그 회사 사장만 하는 줄 알았는데.
클로드 Pro 결제 직후 개막차단 당하는 사람들이 꽤 있다곤 들었는데 그게 제가 될 거라곤.
Oai의 상냥한 경고랑 다르게 시작부터 불꽃꺼져싸다구 맞으니 그 성능이 얼마가 됬든 쓰고 싶은 생각이 팍 사라져 버리네요. 그래놓고 이의제기 신청했는데 '이의제기는 1회밖에 안됩니다.'경고 안내 넣어놓은 것도 그렇고 이게 과연 고객한테 물건을 파는 기업의 태도인가 싶구요. 연휴에 카드사 대응 될 지 모르겠는데 그냥 카드사 분쟁 환불 절차 들어가는 게 빠를 거 같군요.
누워서 눈 감을때마다 짜증나서 깨는 걸 반복하다가 그냥 안 자고 제사 지내러 갈 생각.
19
2
115
42,413

很多人可能还没意识到,中国大模型其实已经进入了一段尴尬期。
什么叫尴尬期呢?
你如果养过猫,尤其是布偶这种猫,应该知道它从小长大的时候,会经历一段尴尬期。
旧毛掉了,新毛还没完全长出来,看起来多少有点别扭。
但再过一段时间,等新毛长齐了,漂亮的那个状态又会回来。
我觉得现在国内大模型差不多就是这个阶段,核心主要是有三个问题。
第一个,就是模型越训越大,但训练算力开始有点跟不上了。
现在大家都在往更大的模型走,5T、8T、10T 这种规模也开始被摆到台面上。
比如阿里在本次的云栖大会上提到,未来可能会训练 5T 到 10T 参数规模的模型。
Kimi、GLM 也都在继续往更大规模走。
但问题是,模型规模可以继续往上加,训练卡没有那么容易增加。
大家都知道 Scaling 还没有完全走到头,但在国内,算力确实已经越来越容易变成一个现实限制。
第二个是推理,或者说模型上线之后怎么稳定提供服务。
之前梁文锋在那个所谓流出的DeepSeek投资人会议纪要里也提到过,国内之前为什么很多 MoE 模型会把激活参数控制在几十 B,一个重要原因就是推理资源。
因为模型训出来是一回事,能不能长期、稳定、大规模地给用户用,是另外一回事。
虽然那个会议纪要出来之后,Kimi 也发了 K3 这种2.4T参数的模型,但这个问题还是没有被缓解。
一些新模型(就比如K3还有刚发的Step5Preview)刚上线的时候速度很好,但很快可能就会遇到限速、排队、额度收紧之类的情况。
这说明推理算力的问题其实还没有完全解决。
我们的团队们很难像 OpenAI 那样,时不时直接给用户 reset 一轮额度。
因为模型越大,每多放一点额度,背后都对应着真实的推理成本。
第三个,就是价格和定位的问题。
模型越做越大,推理成本越高,价格自然也很难一直维持在原来的水平。
但国内模型之前比较明显的两个优势,一个是开源,一个是性价比。
所以如果价格慢慢往上涨,就会出现一个新的问题:
如果价格差距越来越小,那用户为什么一定要选择国内模型?
尤其到了 Agent 时代,一次任务消耗的 Token 可能会比普通聊天高很多,价格会变得比以前更敏感。
最后很可能还是会回到一个很朴素的问题:效果差不多的情况下,谁便宜就用谁。
那就会有人选择赔本赚吆喝喽,当然我没有特指某些模型哈。
包括 DeepSeek 自己,其实也经历过价格调整。
所以我觉得,国内大模型现在确实处在一个比较微妙的阶段。
模型做大之后,推理算力又会成为新的限制。
推理成本上升之后,价格也需要调整,但价格一上去,又会影响原本的性价比优势。
有点像猫长大的尴尬期。
旧毛已经开始掉了,新毛还没有完全长出来。
接下来这段时间,得看国内厂商怎么把这几个问题一起解决掉(下一条我会聊这个)。

26
9
181
35,158


中秋快乐!刚刚看到一篇新论文 Memory Attention,感觉可能是个划时代的新注意力架构,给大家分享一下。
MA这篇的核心是Transformer 里的 V,可能根本没必要每次都重新算。
所以直接开始动 Attention 里最经典的 QKV 结构了。
传统 Attention 里,每个 token 都要从当前 hidden state 重新计算:
Q = XWq
K = XWk
V = XWv
但本文作者 @Jo1uck 问了一个很朴素的问题:
V 里面有多少东西,真的需要每次根据上下文重新算?
同一个 token 在不同句子里,显然存在大量可以复用的信息。
于是他们参考 Engram 这类 Memory 架构,给每个 token 建了一套可学习的 memory,然后更激进地把独立的 value projection 直接干掉:
V = K + Memory[token]
K 负责保留上下文信息,Memory 负责保存 token 自身可以复用的信息。
这样推理时,原来计算 V 的一次矩阵乘法,基本就变成了:查表 + 加法(这会大幅减少计算量)。
然后事情开始变得有意思了。
因为 Memory 只跟 token ID 和层数有关,所以甚至可以提前知道要读哪块数据,直接把这部分参数扔到 CPU,GPU 需要的时候提前 Prefetch。
实验里,MA-Offload 模型总参数是普通模型的 2.08 倍,但 GPU 上实际常驻的参数反而比普通 Transformer 少了 7.38%,推理延迟基本维持在同一水平。
训练上,在两个不同规模实验里,达到相同 loss 所需 token 数分别提升到了 1.42× 和 1.16× 的 token efficiency,也就是大约少用 29.6% 和 13.8% 的训练 token。
下游平均成绩也基本都比对应的 Standard Attention 更高。
更骚的是,作者还提出了一个 MA-Recall:
既然历史 V 可以通过 K + token memory 重新构造,那么理论上甚至不用一直保存完整的 V Cache,只保存 K 和 token ID,在需要的时候把 V 重建出来。
按论文的理论计算,这部分 KV Cache 可以砍掉接近一半,不过目前还只是分析,没有进入实际推理实验。
我觉得这篇的方向挺值得关注的。
过去大家做 Memory,更多是在 Transformer 外面继续加东西。
Memory Attention 开始反过来问:既然 Memory 已经能记住这些东西,那 Transformer 里面原来那些计算,是不是可以直接删掉?
当然论文自己写的也很克制:MA 用了更多参数,所以目前的收益还不能证明全部来自架构本身,而不是单纯的参数量增加。
但如果这条路继续成立,下一代模型的变化可能不只是 Attention 越做越复杂。
也可能是我们用了快十年的 QKV,终于开始有人认真考虑:哪些东西其实根本不用算。


Could this be a direction for future model architectures?
Introducing Memory Attention (MA).
alphaxiv.org/abs/2609.28399

13
79
493
64,376


🚨DeepSeek 被曝正在开发轻量级开源小模型。
据知情人士透露,梁文锋近期向投资人表示, @deepseek_ai 内部正在测试一款轻量化模型,而且这东西已经可以在普通游戏显卡上稳定运行。
更关键的是,内部测试显示,这款模型已经能够处理用户绝大多数日常任务(Agentic任务?)。
这就有意思了🤔
DeepSeek 过去给人的印象一直是:用更少的算力,把大模型做到尽可能强。
现在看,他们可能还在继续往另一个方向做:轻量级开源小模型。
不只是把模型做便宜,而是直接把模型压到消费级 GPU 上(但5090和4090现在已经不算消费级显卡了🤣)。
目前这款模型还没有公布参数、名称和发布时间。
如果最后真的能做到“一张游戏显卡(别5090就行),本地解决大部分日常任务”,那 DeepSeek 下一步卷的可能就不是 API 价格了,而是本地 AI 的成本底线。
真做成了,我愿意把梁圣纹在身上😭
97
36
484
73,612